Google EmbeddingGemma 2 объединяет поиск по тексту, коду, фото, видео и аудио локально
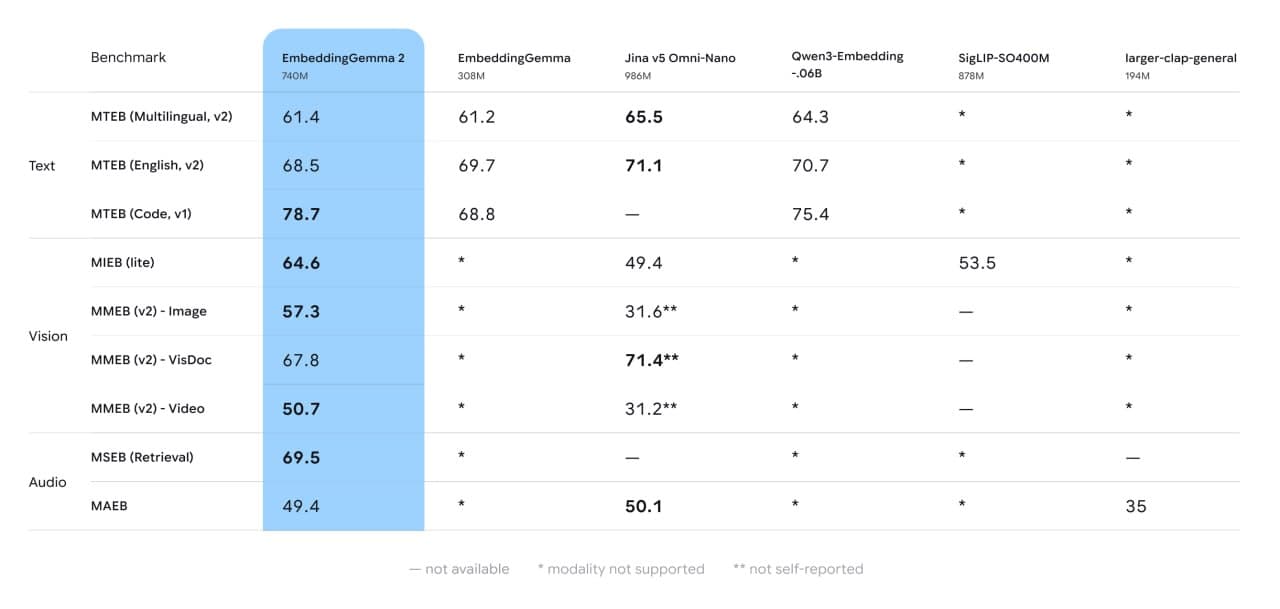
Google выпустила EmbeddingGemma 2 для локального мультимодального поиска по тексту, коду, изображениям, видео и аудио. Модель поддерживает модульную загрузку и Apache 2.0.
Google выпустила EmbeddingGemma 2 — локальную мультимодальную модель для поиска по тексту, коду, изображениям, видео и аудио. Ключевая особенность новинки заключается в том, что разные типы данных переводятся в единое пространство числовых представлений, поэтому один поисковый запрос может использоваться для работы с несколькими форматами.
Единое пространство для разных типов данных
EmbeddingGemma 2 позволяет сопоставлять текстовые запросы с содержимым различных форматов. Например, пользователь может сформулировать запрос обычными словами и найти подходящий момент в видео, фотографию, фрагмент кода или аудиозапись. При этом для каждого формата не обязательно заранее создавать отдельный способ поиска.
Такой подход может быть полезен для локальных поисковых систем, которые работают сразу с несколькими типами данных. Модель переводит информацию в числовые представления, благодаря чему её можно использовать для построения индексов и поиска семантически похожего содержимого.
Модульная архитектура и локальная обработка
Полная версия EmbeddingGemma 2 содержит 740 млн параметров, однако модель имеет модульную архитектуру. Это позволяет не загружать в память компоненты, которые не нужны для конкретной задачи.
- Для работы только с текстом и кодом требуется 270 млн параметров.
- Конфигурация для текста и изображений использует 440 млн параметров.
- Вариант для текста и аудио — 570 млн параметров.
- Полная мультимодальная конфигурация включает 740 млн параметров.
На Pixel 11 Pro текстовая версия занимает около 191 МБ активной памяти, а полная мультимодальная — около 567 МБ. Обработка может выполняться непосредственно на устройстве, без отправки данных в облако.
Более длинный контекст и компактные индексы
Контекст для текста в EmbeddingGemma 2 увеличен до 8192 токенов. Поиск по коду новая версия показывает результат на 14% выше, чем EmbeddingGemma первого поколения.
Отдельно Google отмечает возможность уменьшать размер векторов с 768 до 128 измерений. Это позволяет сокращать объём поискового индекса до шести раз, что особенно важно для систем, где необходимо хранить большое количество векторных представлений.
Открытая модель и поддержка инструментов
EmbeddingGemma 2 распространяется под лицензией Apache 2.0. Модель уже работает через sentence-transformers, Transformers, MLX, Ollama, LM Studio, vLLM и другие популярные инструменты.
Для разработчиков это означает возможность использовать EmbeddingGemma 2 в существующих рабочих процессах для создания локального семантического поиска и мультимодальных индексов. При этом конкретная конфигурация может подбираться под используемые типы данных и доступную память.
Подпишись, чтобы
ничего не пропустить
Бесплатные промпты для нейросетей на русском, новости ИИ и уроки по генерации фото, видео и текста, доступные на всех площадках.