Google представила Gemini 3.8 Flash TTS для генерации голосов по промпту
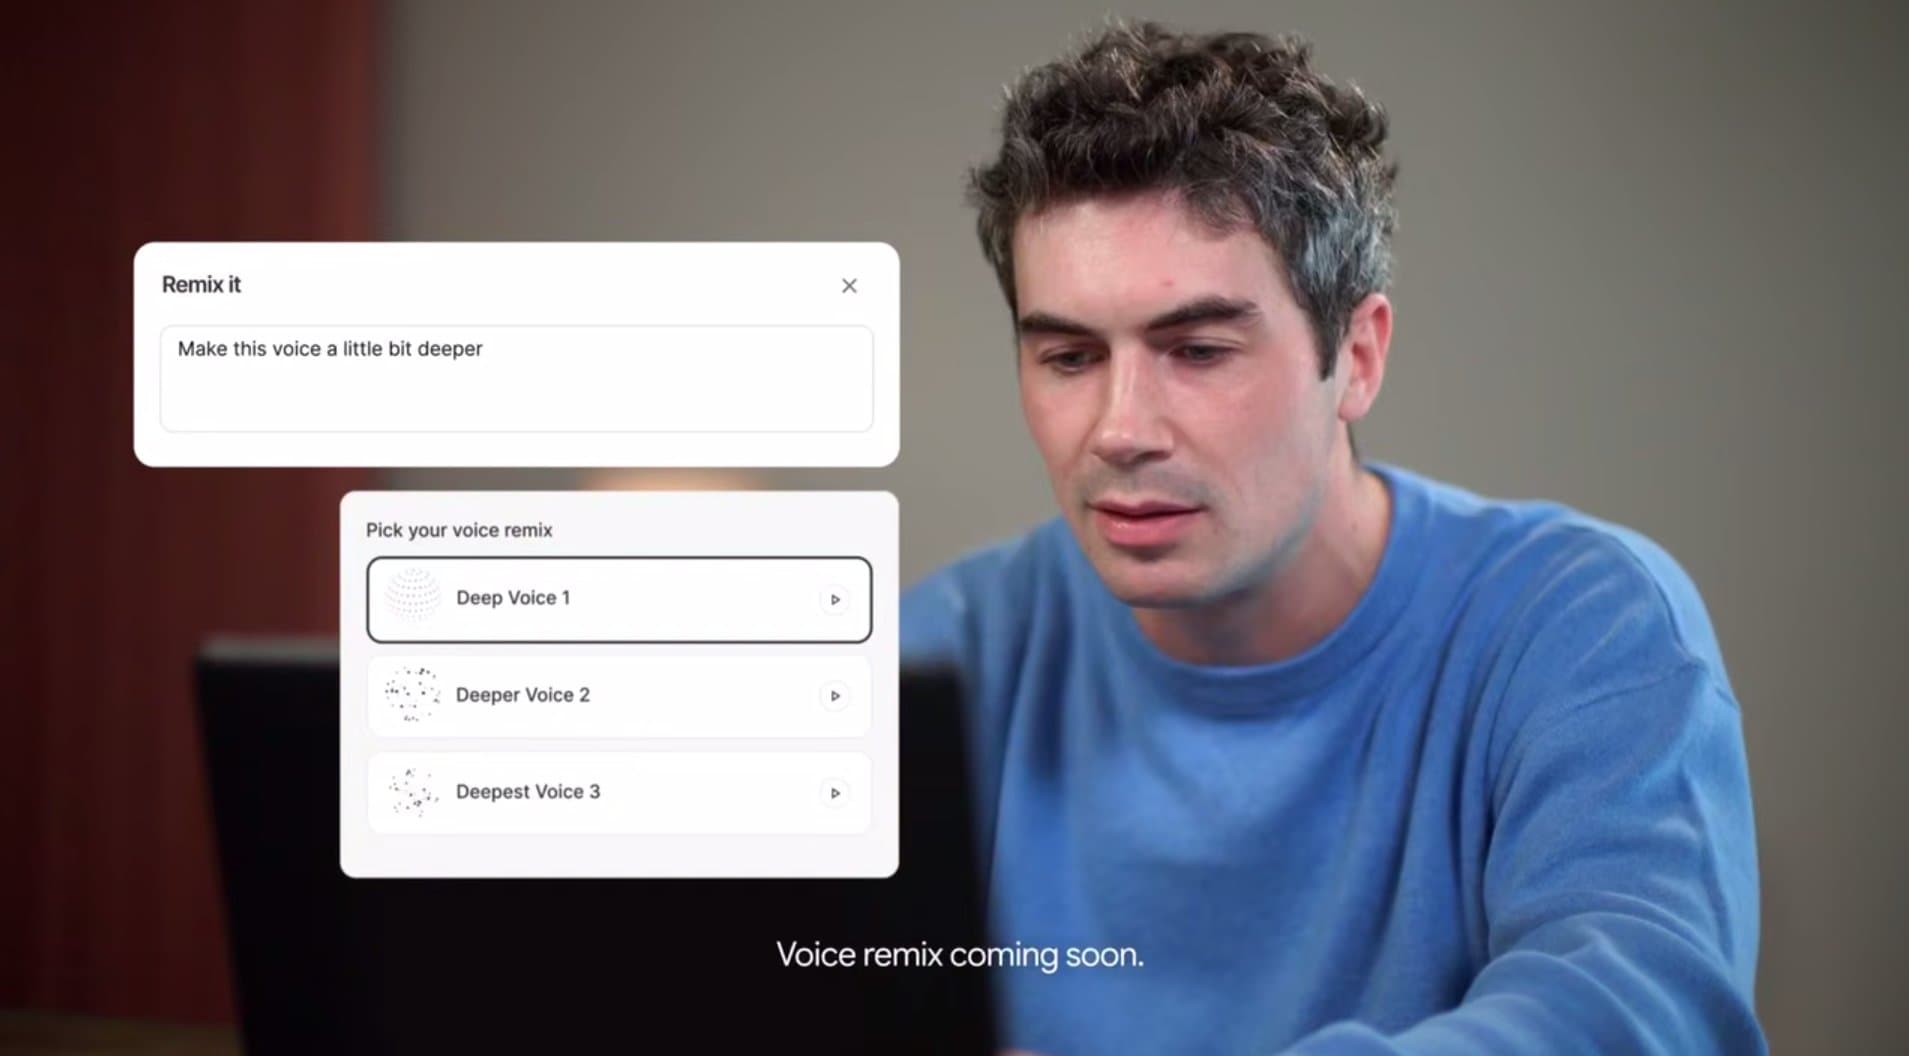
Google выпустила модели Gemini 3.8 Flash TTS и Flash-Lite TTS: теперь голос, акцент и эмоции диктора можно гибко настраивать обычным текстом.
Компания Google представила новые модели преобразования текста в речь — Gemini 3.8 Flash TTS и более доступную Flash-Lite TTS. Главным новшеством стало создание уникальных голосов с помощью обычных текстовых описаний, что избавляет разработчиков и авторов контента от необходимости ограничиваться фиксированными списками стандартных дикторов.
Создание тембра по промпту и безопасное клонирование
Gemini 3.8 Flash TTS позволяет гибко сконструировать голос под конкретную задачу или персонажа. В текстовом запросе можно задать роль, тембр, акцент и индивидуальную манеру речи более чем для 100 языков и диалектов. Для быстрых интеграций разработчикам также доступна встроенная библиотека, насчитывающая свыше 2000 готовых голосов.
Кроме генерации с нуля, инструмент поддерживает клонирование голоса по короткому 30-секундному образцу. Чтобы предотвратить дипфейки и неправомерное использование, Google требует обязательную запись согласия от владельца голоса. Все сгенерированные аудиодорожки защищаются цифровым водяным знаком SynthID, позволяющим идентифицировать работу нейросети.
Тонкая режиссура речи и многопользовательские диалоги
Модель получила расширенные инструменты управления актерской подачей. Для каждой отдельной реплики можно настраивать:
- темп речи, эмоциональное состояние и акцент;
- характерную актерскую интонацию;
- невербальные реакции: естественные вздохи, смех и короткие паузы.
Gemini 3.8 Flash TTS умеет синтезировать диалоги двух персонажей в одном аудиофайле, сохраняя стабильность и узнаваемость каждого тембра на протяжении длинных записей. Это решает распространенную проблему генеративного TTS, когда звучание персонажей искажалось в процессе длительного повествования.
Разделение моделей и доступность
Google разделила технологию на две версии в зависимости от сценариев использования:
- Gemini 3.8 Flash TTS разработана для комплексной режиссуры, озвучивания сюжетных персонажей и сложных творческих проектов.
- Gemini 3.8 Flash-Lite TTS оптимизирована под высокую скорость и низкую стоимость обработки, что делает ее выбором для массового дубляжа, локализации контента и масштабируемых голосовых агентов.
Обе модели уже разворачиваются в Gemini API и Google AI Studio. Флагманская Flash TTS интегрируется в Gemini Notebook, а облегченная Flash-Lite TTS добавляется в видеоредактор Google Vids для автоматической генерации закадрового голоса.
Подпишись, чтобы
ничего не пропустить
Бесплатные промпты для нейросетей на русском, новости ИИ и уроки по генерации фото, видео и текста, доступные на всех площадках.