OmniHuman 2.0 от ByteDance генерирует 5 минут видео из фото на 40% дешевле
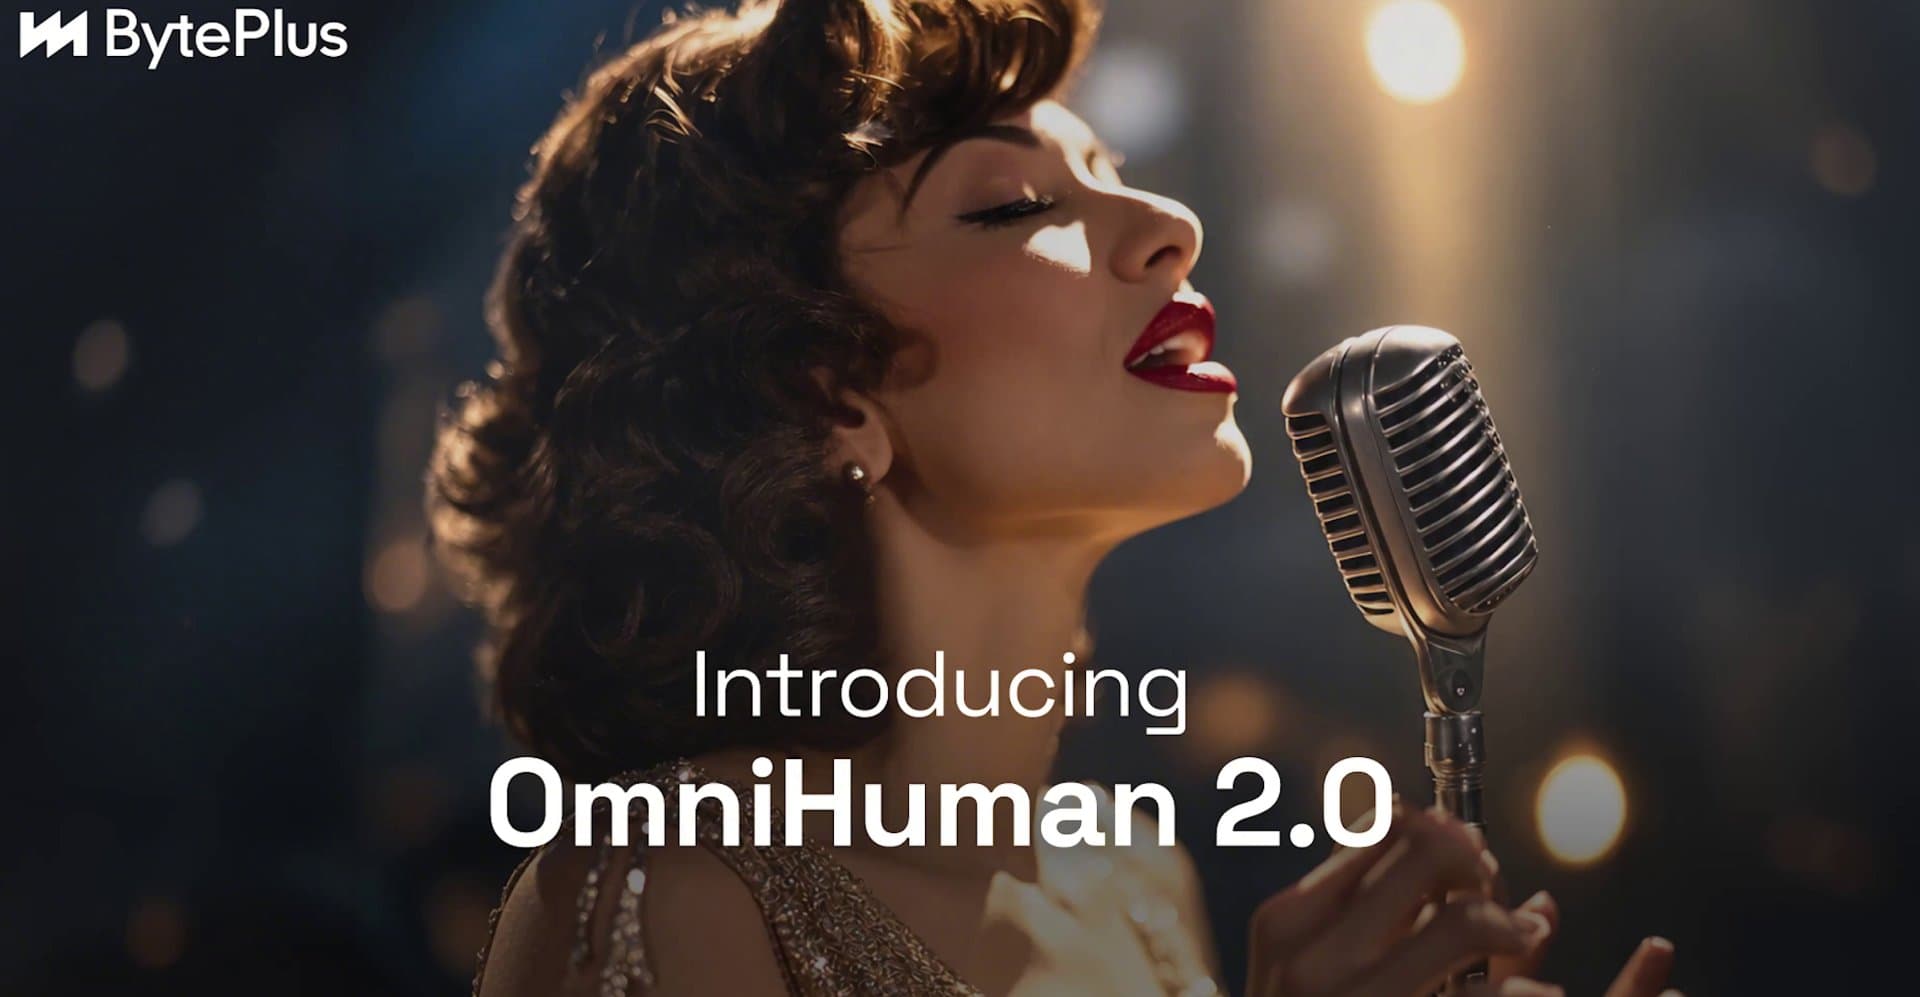
ByteDance представила OmniHuman 2.0: модель создаёт видео из одной фотографии и аудио длительностью до пяти минут, а стоимость генерации снизилась с $0,12 до $0,07 за секунду.
ByteDance представила OmniHuman 2.0 — модель для генерации реалистичных видео с человеком на основе одной фотографии и аудиодорожки. Продолжительность роликов теперь может достигать пяти минут, а стоимость генерации одной секунды видео снизилась с $0,12 до $0,07. Это расширяет возможности создания цифровых персонажей для презентаций, обучающих материалов и видеоконтента без необходимости снимать человека в кадре.
Как работает генерация видео из фотографии
OmniHuman 2.0 превращает статичное изображение человека в видео, синхронизированное с загруженным звуком. В качестве аудиодорожки можно использовать речь, музыку или диалог. На основе этих данных модель генерирует движения губ, мимику и жесты персонажа.
Особенность подхода заключается в том, что система ориентируется не только на звучание отдельных слов. Она также анализирует интонацию, эмоциональную окраску и общий смысл аудио. Благодаря этому движения персонажа должны соответствовать характеру речи и происходящему в звуковой дорожке, а результат не сводится к простой синхронизации открывания рта с голосом.
Такой формат позволяет создавать видео с говорящим человеком, используя фотографию в качестве визуальной основы. Пользователю не требуется записывать полноценное выступление перед камерой: ключевыми исходными материалами становятся изображение и звук.
Видео до пяти минут без склейки фрагментов
Одно из главных изменений в OmniHuman 2.0 — увеличение максимальной продолжительности генерации. Если прежде модель могла создавать ролики длиной до 60 секунд, то теперь этот показатель составляет пять минут.
При этом видео формируется одним непрерывным дублем, а не собирается из нескольких коротких фрагментов. Для практического использования это важно: длинный материал можно создавать как единое выступление, не закладывая в процесс обязательную склейку отдельных генераций.
Увеличение продолжительности особенно актуально для сценариев, в которых персонажу необходимо произнести развернутый текст. Среди возможных применений — виртуальные ведущие, презентационные ролики, образовательные видео и озвученные объяснения. В этих случаях возможность использовать одну фотографию вместо полноценной видеосъёмки может упростить подготовку визуального материала.
При этом заявленная продолжительность сама по себе не гарантирует идеального результата в каждом сценарии. Качество синхронизации, естественность жестов и соответствие мимики содержанию по-прежнему имеют значение при оценке готового ролика.
Стоимость генерации снизилась более чем на 40%
Вместе с увеличением длительности видео ByteDance снизила стоимость генерации одной секунды с $0,12 до $0,07. Это сокращение более чем на 40% относительно прежней цены.
Изменение заметно и при расчёте стоимости длинных роликов. Пятиминутное видео продолжительностью 300 секунд обойдётся в $21 по новой ставке. При прежней цене аналогичная генерация стоила бы $36. Таким образом, разница составляет $15 на одном ролике.
Снижение стоимости может быть особенно полезно тем, кто планирует создавать серию видео с одним цифровым персонажем или регулярно выпускать материалы на основе аудиозаписей. Однако итоговые расходы зависят от объёма генерации, поэтому перед использованием модели в постоянном производственном процессе стоит оценить потребность в длительности роликов и количество создаваемого контента.
Для каких задач подойдёт OmniHuman 2.0
Модель представляет интерес для авторов контента, образовательных проектов и команд, которым необходимо превращать готовую речь в видео с визуальным персонажем. Вместо записи нового выступления можно использовать фотографию и подготовленную аудиодорожку, а затем получить ролик с синхронизированными губами, мимикой и жестами.
Ознакомиться с продуктом можно на официальной странице BytePlus. Представленные сведения описывают увеличение максимальной длительности и снижение стоимости, но сами по себе не позволяют сделать выводы обо всех условиях доступа к модели или качестве генерации в различных сценариях.
Главное изменение в OmniHuman 2.0 — сочетание более длинных видео, непрерывной генерации и сниженной стоимости. Это делает технологию потенциально удобнее для создания развернутого контента из фотографии и звука.
Подпишись, чтобы
ничего не пропустить
Бесплатные промпты для нейросетей на русском, новости ИИ и уроки по генерации фото, видео и текста, доступные на всех площадках.