Qwen-Audio-3.1-TTS позволяет управлять голосом текстовыми командами
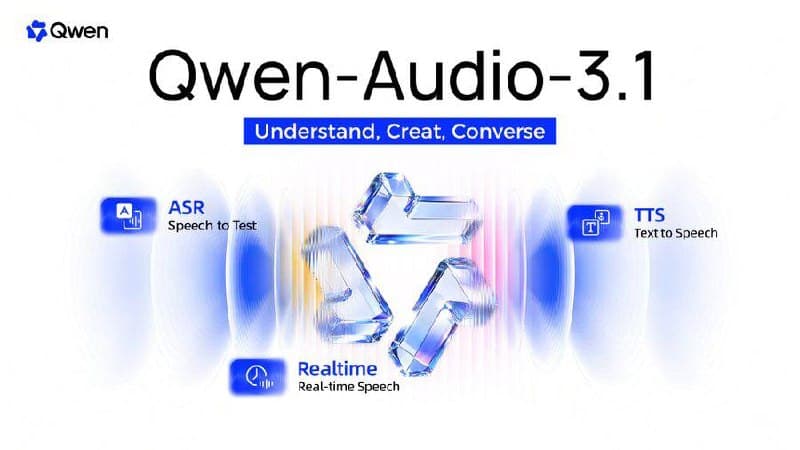
Alibaba представила Qwen-Audio-3.1-TTS с клонированием голоса и управлением подачей через текст. Модель поддерживает 16 языков и 86 тегов для речи.
Alibaba представила Qwen-Audio-3.1-TTS — модель синтеза речи с клонированием голоса и детальным управлением манерой звучания. Система поддерживает 16 языков, включая русский, а ключевая особенность заключается в возможности задавать характеристики речи обычным текстовым описанием.
Управление голосом через текст
Qwen-Audio-3.1-TTS позволяет не ограничиваться выбором голоса и текста для озвучки. Пользователь может текстовой командой указать, как именно должна звучать реплика: попросить говорить быстрее или тише, передать испуг или задать манеру радиоведущего.
Для более детального контроля в модели предусмотрены 86 тегов. Они позволяют добавлять в речь такие элементы, как смех, вздохи, дыхание и паузы. Это дает возможность управлять не только содержанием фразы, но и отдельными особенностями ее подачи.
Клонирование голоса и работа с языками
Для клонирования Qwen-Audio-3.1-TTS достаточно предоставить пример исходного голоса. Согласно представленным материалам, модель способна работать даже с шумными записями. При переходе на другой язык она также умеет сохранять тембр клонированного голоса.
Поддержка 16 языков, в число которых входит русский, расширяет сценарии применения технологии для многоязычной озвучки. При этом сохранение тембра при смене языка позволяет использовать один голос в контенте на разных языках.
Длительность и качество генерации
Qwen-Audio-3.1-TTS способна генерировать до трех минут речи за один проход. Максимальное заявленное качество составляет 48 кГц. В сочетании с управлением подачей и набором тегов это делает модель ориентированной на создание более детализированной синтетической речи.
Практически такой подход может быть полезен для озвучки материалов, где важны темп, паузы, эмоциональная подача и дополнительные голосовые эффекты. Вместо отдельного ручного редактирования каждого параметра пользователь может задавать нужную манеру непосредственно в текстовом запросе.
Что представила Alibaba
Qwen-Audio-3.1-TTS объединяет синтез речи, клонирование голоса и текстовое управление подачей. Среди заявленных возможностей — поддержка 16 языков, 86 тегов для управления деталями звучания, работа с шумными образцами голоса, сохранение тембра при смене языка и генерация до трех минут аудио за один проход с качеством до 48 кГц.
Подробнее о представлении Qwen-Audio-3.1-TTS Alibaba рассказала в материалах о модели.
Подпишись, чтобы
ничего не пропустить
Бесплатные промпты для нейросетей на русском, новости ИИ и уроки по генерации фото, видео и текста, доступные на всех площадках.