Qwen Image 2.1: генерация и редактирование фото с прозрачным фоном
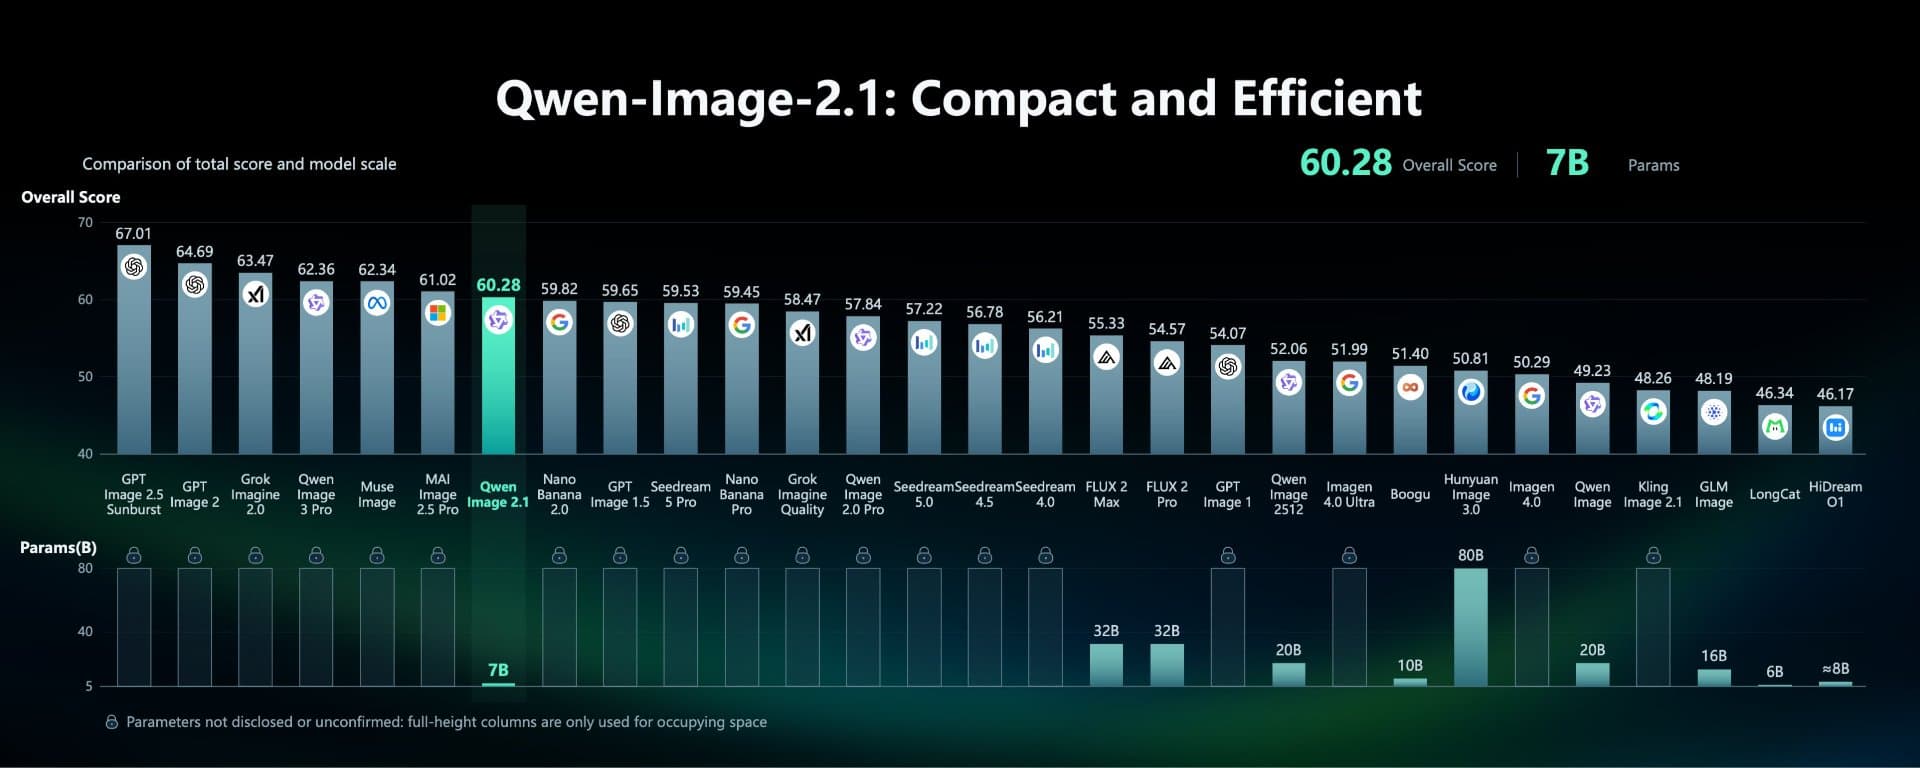
Qwen представила нейросеть Qwen Image 2.1 для генерации и редактирования фото. Модель поддерживает нативную прозрачность, работу с 10 референсами и сохраняет вид продукта при правках.
Команда разработчиков Qwen представила масштабное обновление своей визуальной модели — Qwen Image 2.1. Этот релиз знаменует переход от узкоспециализированных инструментов к универсальным системам, где генерация и глубокое редактирование графики происходят в рамках единого пайплайна. Модель с 7 миллиардами параметров получила открытые веса и ряд уникальных функций, которые ранее требовали использования нескольких сторонних сервисов или сложных цепочек из разных нейросетей.
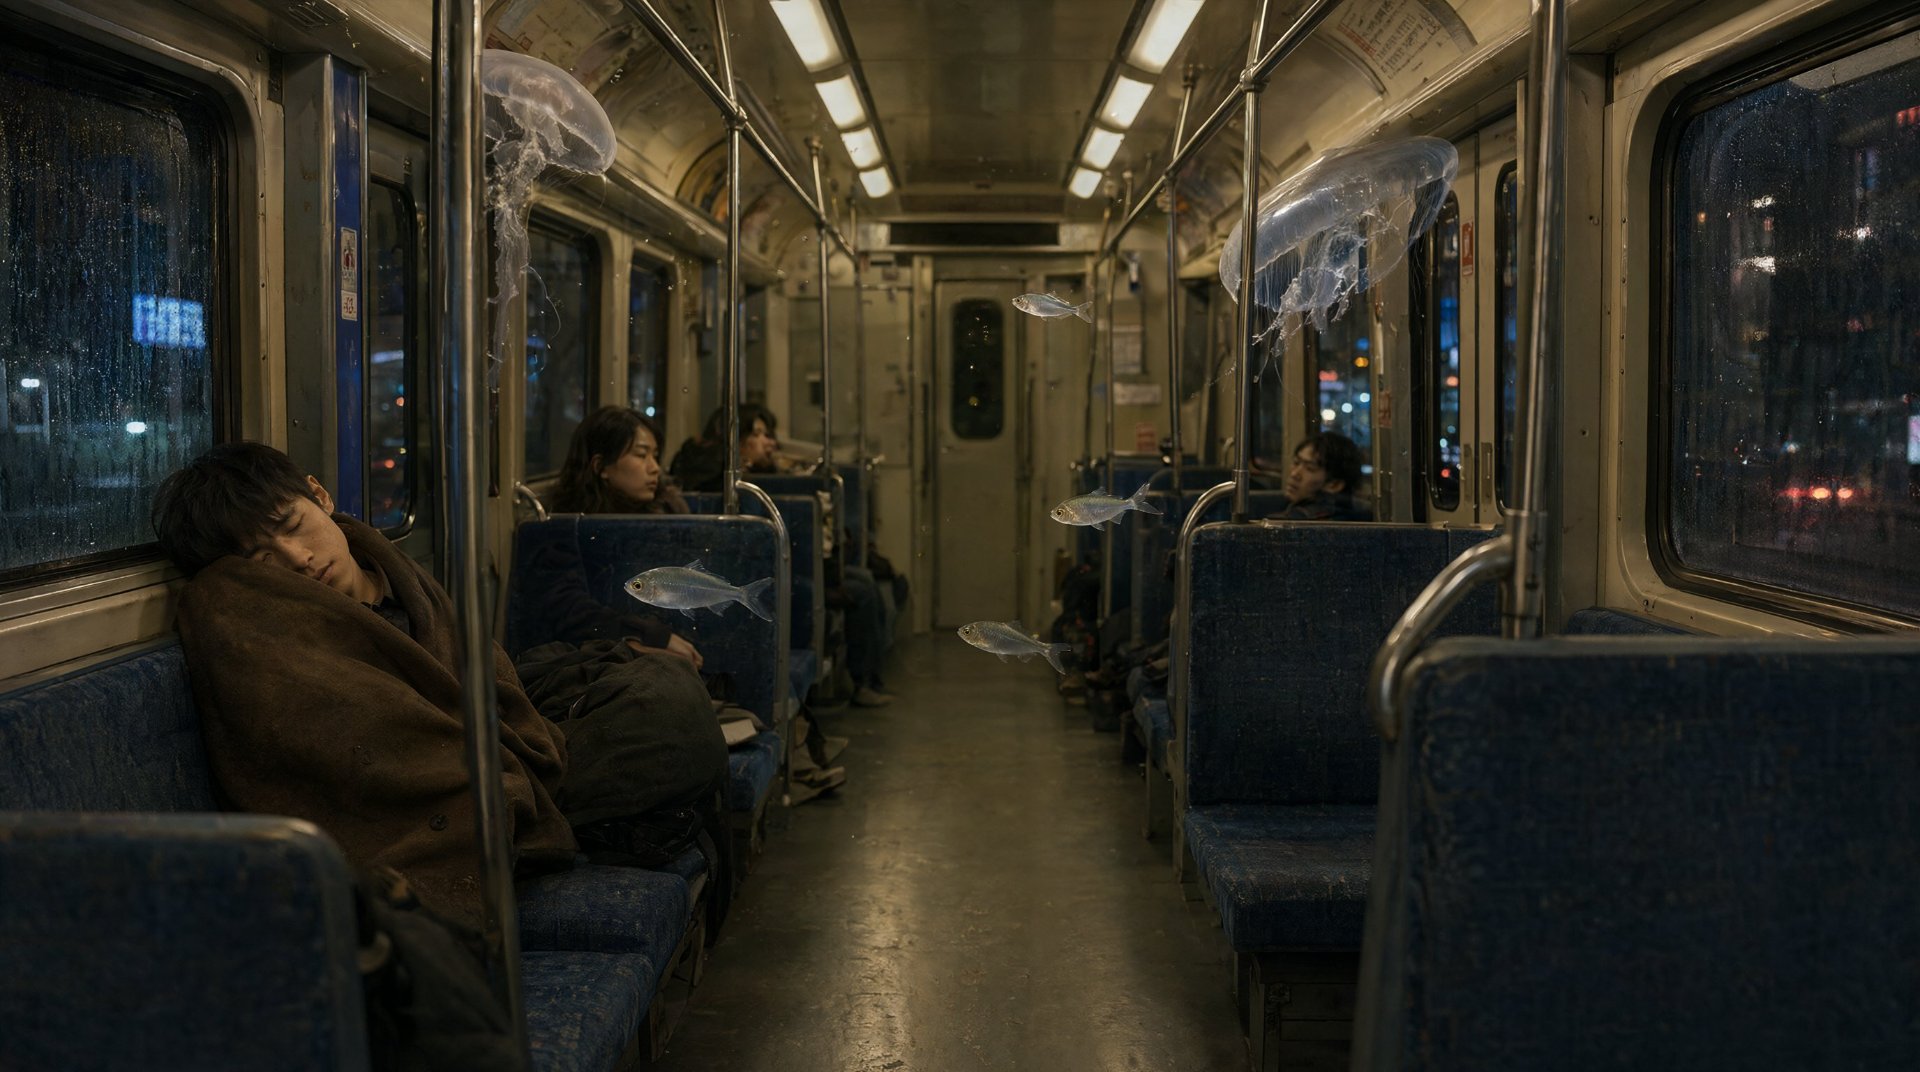
Нативная прозрачность и работа со слоями
Одной из самых востребованных функций Qwen Image 2.1 стала встроенная поддержка прозрачности (RGBA). В отличие от большинства популярных моделей, которые генерируют изображения на сплошном фоне, новая разработка умеет сразу создавать объекты с прозрачными областями. Это избавляет дизайнеров от необходимости использовать инструменты для удаления фона и позволяет интегрировать сгенерированные объекты в макеты без потери качества на краях.
Возможности работы с фоном в Qwen Image 2.1 делятся на три основных сценария:
Чистая генерация: создание новых объектов сразу на прозрачном слое по текстовому описанию.
Извлечение объектов: автоматическое вырезание центрального элемента из готовой фотографии в отдельный RGBA-файл.
Редактирование: внесение изменений в прозрачные слои без нарушения их структуры.
Такой подход делает модель крайне полезной для создания карточек товаров, рекламных креативов и элементов интерфейса, где важна быстрая изоляция объекта от окружения.
Мультиреференсность и сохранение идентичности
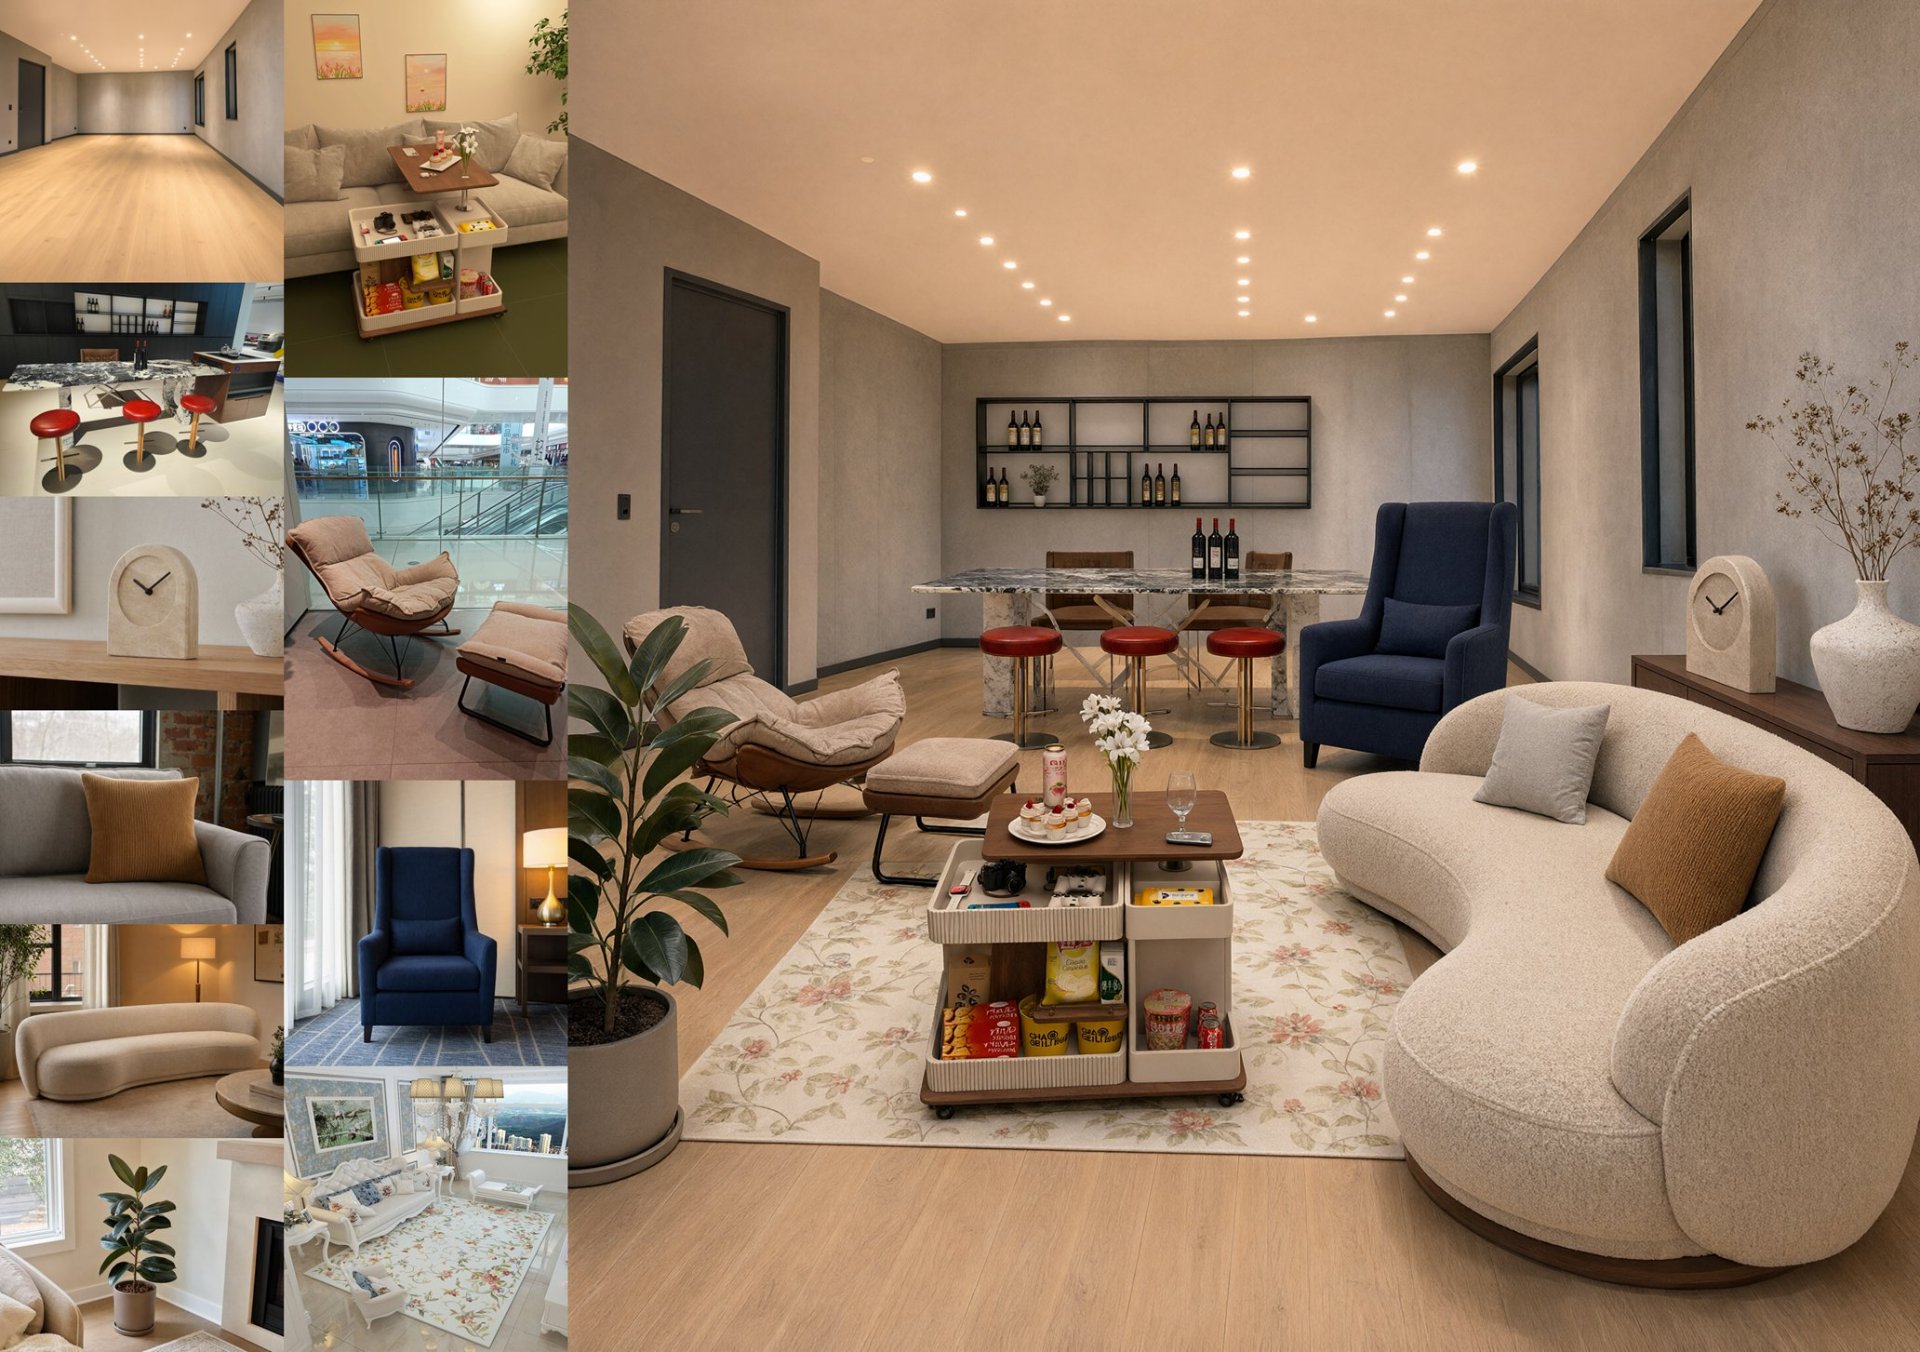
Qwen Image 2.1 существенно расширяет границы управления визуальным стилем. Модель поддерживает одновременную работу сразу с 10 референсными изображениями. Это критически важно для профессиональных задач, где необходимо сохранить облик конкретного персонажа или узнаваемые черты продукта при смене обстановки, позы или освещения.
За понимание контекста, сложных промптов и визуальных подсказок отвечает вспомогательная модель Qwen3-VL-8B. Благодаря такой связке нейросеть лучше интерпретирует нюансы запросов и точнее переносит детали с исходных образцов на итоговый результат. Это находит применение в задачах виртуальной примерки одежды (virtual try-on), где нужно сохранить текстуру ткани и особенности кроя на новом манекене или модели.
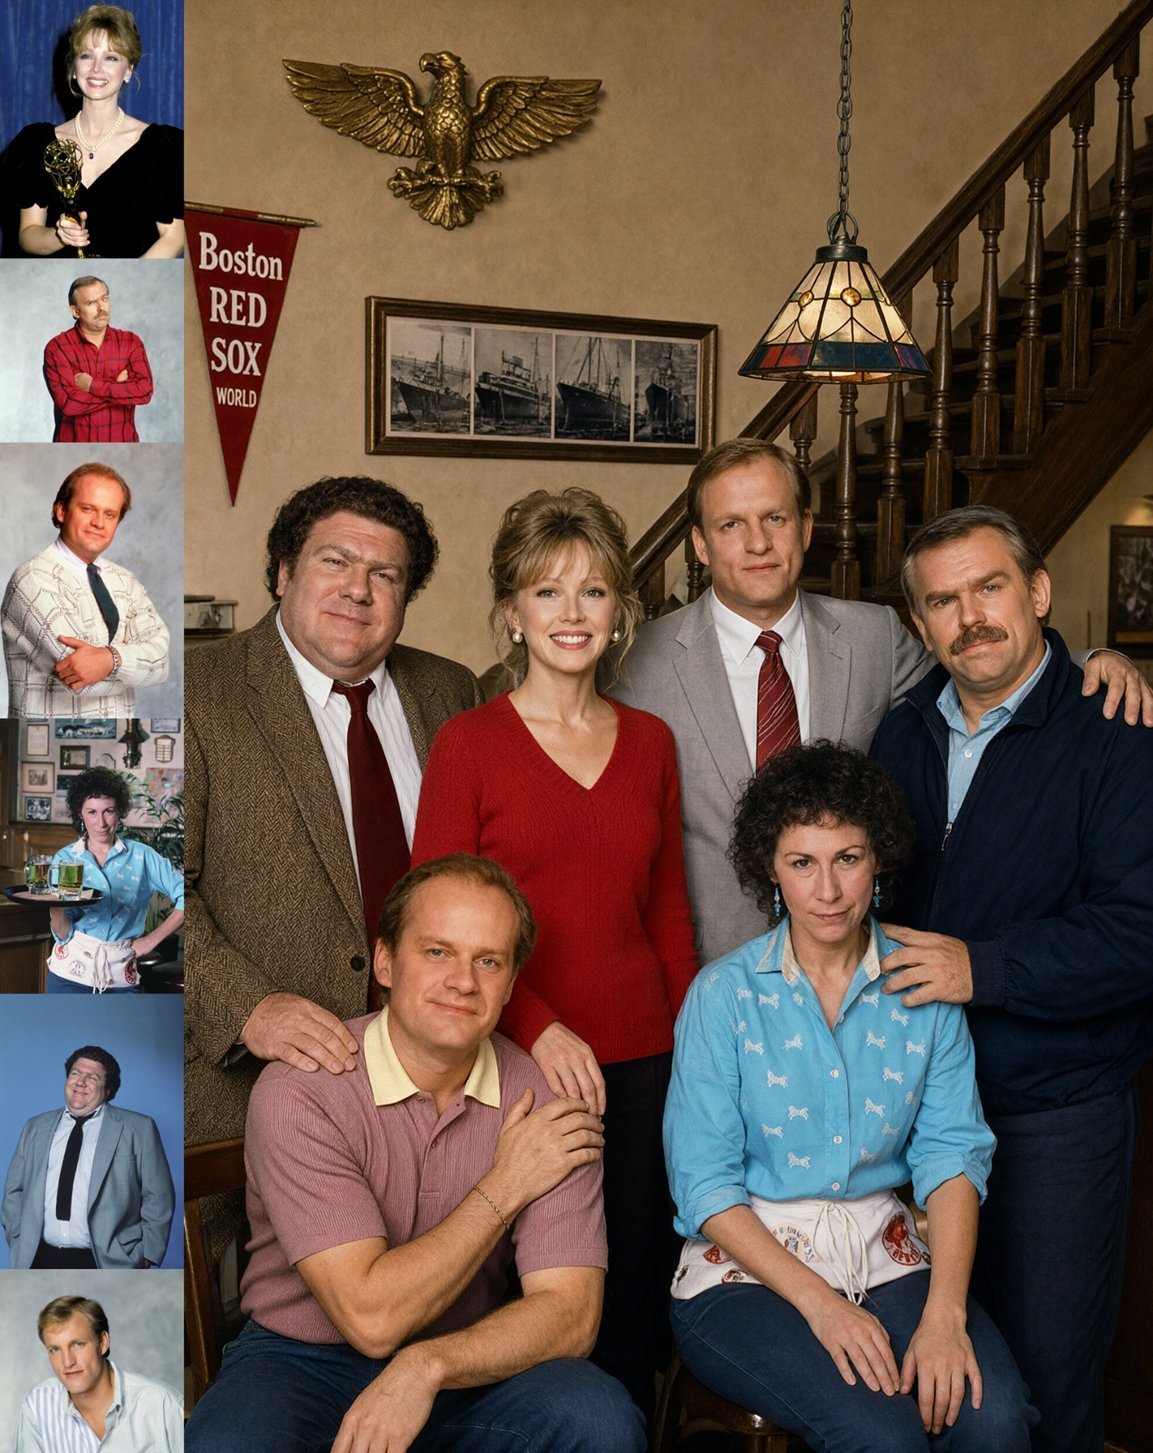
Инструменты локального редактирования и 2K-качество
Разработчики уделили особое внимание инструментам точечного изменения контента. С помощью Qwen Image 2.1 можно выделить конкретную область на снимке и изменить только её, сохраняя остальную часть изображения нетронутой. Алгоритмы модели стремятся к максимальному сохранению внешности человека или геометрии продукта, что позволяет использовать нейросеть для профессиональной ретуши в коммерческих каталогах.
Помимо функциональной гибкости, модель предлагает улучшенные технические характеристики:
Нативное разрешение 2K: поддержка детализированных изображений высокого качества.
Работа с текстом: более корректное отображение надписей внутри графики.
Специализированные форматы: улучшенная генерация панорамных снимков и сложной инфографики.
Объединение генерации, редактирования и функций удаления фона в одной модели позволяет значительно оптимизировать рабочие процессы и снизить требования к вычислительным ресурсам. Больше нет необходимости переключаться между разными архитектурами — весь цикл создания контента замыкается внутри Qwen Image 2.1.
Опробовать возможности новой версии можно уже сейчас: разработчики опубликовали открытые веса на Hugging Face. Подробная техническая документация и примеры работы доступны в официальном блоге проекта.
Подпишись, чтобы
ничего не пропустить
Бесплатные промпты для нейросетей на русском, новости ИИ и уроки по генерации фото, видео и текста, доступные на всех площадках.